
生成AIの仕事に関心はあるものの、「モデル開発の経験がないと転職できないのでは」と感じているデータエンジニアの方へ。ソフトバンクが2026年7月22日に始めた「GaranAI(ガランエーアイ)」のベータ版は、生成AIの競争軸がモデルだけでなく、学習データの権利、品質、安全性、流通設計へ広がっていることを示すニュースです。
とくに、メディアや事業会社でデータ基盤を担当してきた30代前半の方にとって、これまでのデータ整備・アクセス管理・品質監視の経験を「生成AIデータエンジニア転職」へつなげるヒントがあります。発表内容を正確に整理したうえで、評価されやすいスキルと企業研究の進め方を見ていきましょう。
📄 GaranAIのベータ版で何が始まったのか
ソフトバンクは、日本のコンテンツ産業と生成AI開発の両立を目指すデータエコシステム基盤「GaranAI」のベータ版を公開し、同日からコンテンツ保有者とデータ利用事業者の申し込みを受け付けました。ベータ版では一部のコンテンツ保有者からデータを預かり、AI開発事業者などによる利用検証を進め、2027年1月以降の正式提供を目指すとしています。名称はベータ版のコードネームで、正式提供時に変わる可能性があります。
仕組みの中心は、新聞社、出版社、ウェブサービス企業、エンターテインメント企業などが持つデータを、そのまま渡さずに加工して流通させることです。預かった元データを、意味や事実関係を保ちながら表現や構造を変更し、復元しにくい「派生データ」に変換。利用者は、そこから用途別の形式へ再構築した「加工データ」を使います。
ベータ版でデータ提供を予定する企業・団体には、共同通信社、産業経済新聞社、信濃毎日新聞、スポーツニッポン新聞社、デーリー東北新聞社、奈良新聞社、毎日新聞社、室蘭民報社が挙げられています。将来は放送、教育、博物館、製造、小売、自治体などにも対象を広げる方針です。
| 確認項目 | 発表で確認できる内容 | 転職を考える人への意味 |
|---|---|---|
| 提供段階 | 2026年7月22日にベータ版を開始 | 完成品の運用だけでなく、実証・改善を担う経験が重要になる段階です |
| データ処理 | 預託データを派生データ、加工データへ多段階で変換 | ETLだけでなく、権利保護と復元リスクを考えた設計が評価対象になり得ます |
| 品質管理 | 専任チームが監視、安全性評価、ロジック改善を継続 | データ品質を継続運用するDataOpsの経験を説明しやすくなります |
| 収益分配 | 利用状況に応じてコンテンツ保有者へ利用料を分配 | 利用履歴や権限、課金につながるメタデータ設計の重要性が増します |
| 今後の機能 | 文脈を保つ加工ロジックやトレンドAPIを追加予定 | API設計、評価、時系列データ処理も周辺スキルになります |
💡 今回の発表は「AIモデルを作れる人だけの話」ではありません。安全に使えるデータを準備し、利用状況を追跡し、品質を改善し続ける人の仕事が前面に出てきた点がポイントです。
📄 生成AIデータエンジニア転職で「データの出どころ」が問われる理由
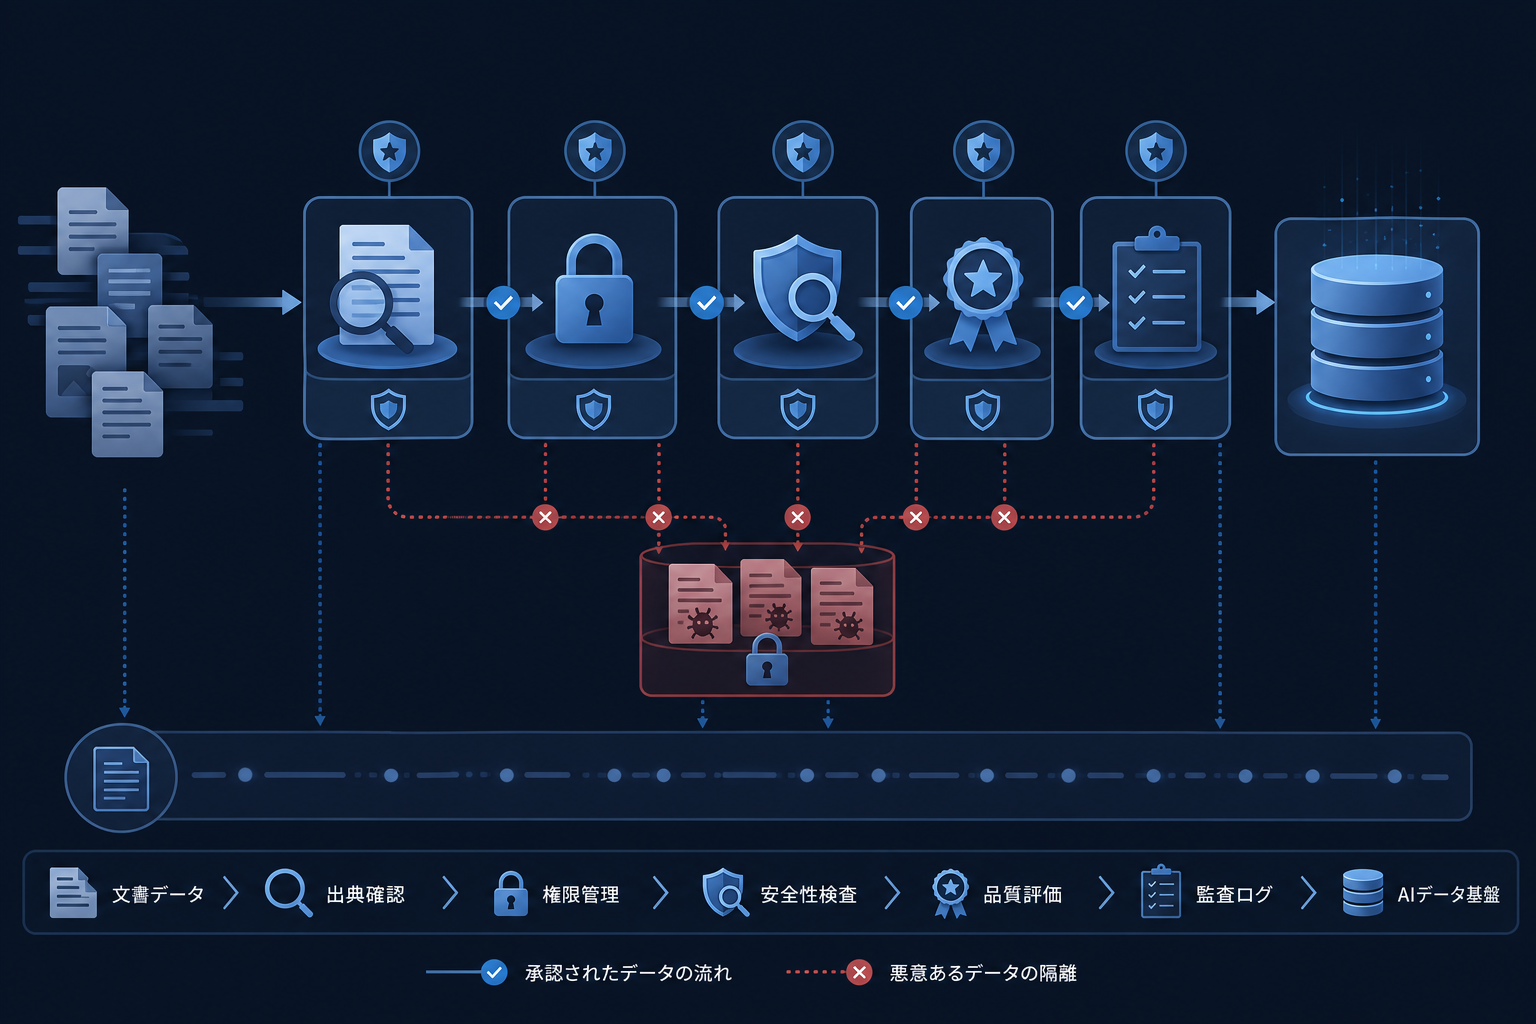
従来のデータ基盤では、欠損や重複を減らし、必要な人が必要なときにデータを使えることが主要な評価軸でした。生成AI向けでは、そこへ「誰が権利を持つデータか」「どの契約条件で使えるか」「どの加工を経たか」「問題が起きたときに利用先を追えるか」が加わります。
これはデータプロベナンス(=データの出どころと加工履歴を追跡できる状態)の考え方です。データカタログを整えた経験、個人情報をマスキングした経験、閲覧権限を職務ごとに分けた経験がある方なら、生成AI専業でなくても接点があります。「社内データ基盤を運用していました」だけで終えず、誰が、どの目的で、どの状態のデータを使ったかまで説明できると強みが伝わりやすいでしょう。
もう一つの焦点が、プロンプトインジェクションです。これは、AIが参照する文書などに悪意のある命令を混ぜ、意図しない処理を引き起こそうとする攻撃を指します。ソフトバンクの発表では、専任チームがデータ収集から加工までを担当し、悪意あるデータの混入リスクを下げると説明しています。
ここから先はCareer Central AI編集部の分析です。生成AIデータ基盤の選考では、パイプラインを速く作る力だけでなく、入力データを信用し過ぎない設計、異常を検知した際の隔離、再処理、監査ログまで語れる人が評価されやすくなると考えられます。セキュリティ部門だけに任せるのではなく、データ基盤側で防御を組み込めるかどうか。これまで地味に見えた運用経験が、むしろ差になりそうです。
自分の経験がどの領域に近いのか迷う方は、担当プロジェクトを「収集」「加工」「権限」「品質」「監視」「障害対応」に分けて棚卸ししてみてください。モデルを学習した経験がなくても、複数の項目で実績を示せる可能性があります。
📄 AIデータガバナンス求人で評価されそうな三つの実務力
AIデータガバナンスは、データの安全な利用を組織として管理する仕組みです。法律の知識だけを意味する言葉ではありません。エンジニア、法務、コンテンツ担当、事業責任者の間で条件を整理し、実装と運用へ落とし込む仕事まで含みます。
1.加工しても意味と品質を保つ力
GaranAIでは、元データを復元しにくくしながら、大意や事実関係を維持する多段階加工を掲げています。ここには難しいトレードオフがあります。保護を強め過ぎればAI学習に必要な情報が失われ、情報を残し過ぎれば元の著作物に近づくおそれがあるためです。
転職活動では、単に匿名化ツールを使った経験を挙げるだけでなく、加工前後の品質を何で測ったかを説明しましょう。サンプリングによる目視確認、件数・分布の比較、意味の保持を測る評価、誤りが出たデータの再処理など、判断過程まで話せると実務像が伝わります。
2.一度作って終わらせない品質運用
公式発表は、継続的なモニタリング、安全性評価、ロジック改善に触れています。生成AI向けのデータは、ニュースや商品情報のように時間とともに鮮度が変わり、利用先によって必要な品質も異なります。そのため、最初のクレンジングだけで品質を保証するのは難しいでしょう。
障害件数、欠損率、重複率、更新遅延、利用者からの指摘などを定点観測した経験があれば、職務経歴書へ具体的に書いておきたいところです。ただし、守秘義務に触れる実数を無理に出す必要はありません。「どの指標を、なぜ選び、基準を外れたときにどう動いたか」を整理すれば十分に説得力が生まれます。
3.技術条件と利用条件を結び付ける力
データ利用に応じた収益分配を行うには、データの識別子、利用者、用途、回数や期間などを追跡できる設計が欠かせません。契約の条件をシステムへ反映し、後から確認できる状態を作る仕事です。
ここは、SaaSの権限設計、API利用量の集計、課金基盤、ライセンス管理を経験した方にも接点があります。自分を「AI未経験」と狭く捉えず、隣接する経験を探してみてはいかがでしょうか。
生成AI・データ基盤職へつながる経験をCareer Central AIで整理する
📄 国のAI政策から見てもデータ基盤は一過性のテーマではない
今回の動きを一社の新サービスとしてだけ見ると、転職判断には材料が足りません。そこで、政策の方向も確認しておきましょう。
経済産業省の「半導体・デジタル産業戦略の進捗状況」は、生成AIの社会実装に必要な要素として、計算資源に加えて専門データの確保やデータ保有者との連携を挙げています。また、適正な利益分配と信頼性の高いデータ流通によってデータスペース(=複数の組織が一定のルールでデータを共有・利用する枠組み)を作る取り組みを支援し、実施者の一つとしてソフトバンクを掲載しています。
国会の総務委員会でも、高品質な日本語データをAI学習に用いることが国内のAI開発力を高める方策になるとの政府答弁があり、情報通信研究機構が持つ日本語データを整備・拡充して民間企業や大学などへ提供する取り組みが説明されています。
ここからは分析です。政策と企業の実証が同じく「高品質な日本語データ」「データ保有者との連携」「安全な流通」を重視しているため、データエンジニアリングとガバナンスを横断する仕事は、短期的な生成AIブームだけに依存しない可能性があります。ただし、GaranAIはまだベータ版であり、正式提供後の事業規模や採用人数は公表されていません。「需要が必ず急増する」と断定せず、関連求人の職務内容が具体化していくかを継続的に見る姿勢が大切です。
💡 ニュースから確認できるのはサービスの開始と設計方針までです。採用人数や年収の上昇は発表されていないため、転職のチャンスは求人票と企業の採用ページで個別に確かめましょう。
📄 ソフトバンクのAI中途採用を調べるときの企業研究ポイント
「ソフトバンク AI 中途採用」と検索する方も、社名や新サービスだけで応募を決めるのは早いでしょう。今回のようなデータエコシステムは、AI開発部門だけで完結しません。法人事業、データ基盤、セキュリティ、法務、品質管理、パートナー連携など、複数部門の協働が想定されます。応募先の職種が、そのうちどの責任を負うのかを確認する必要があります。
求人票で「生成AI」「データ基盤」と書かれていても、仕事内容は企業ごとに違います。新規開発が中心なのか、顧客への導入支援なのか、運用監視なのか。自分がコードを書く比率、社内外の調整に使う時間、扱うデータの種類を面接で聞いておくと、入社後のずれを減らせます。
- ✓ 担当するのはモデル開発、データ加工、基盤運用、顧客導入のどこか
- ✓ データ利用の許諾や契約条件を技術仕様へ反映する責任者は誰か
- ✓ 品質を測る指標と、基準を外れた場合の停止・再処理手順があるか
- ✓ プロンプトインジェクションや機密情報混入をどう検査するか
- ✓ データの出どころ、加工履歴、利用先を追跡できる仕組みがあるか
- ✓ ベータ版から正式提供へ進む際、自分に期待される成果は何か
- ✓ 法務・セキュリティ・コンテンツ担当とどの頻度で協働するか
- ✓ 技術検証の失敗や仕様変更を評価へどう反映するか
面接では「AIに興味があります」より、既存経験との接続を話すほうが効果的です。たとえば、「個人情報を含むデータ基盤で、権限を職種別に分離し、監査ログを運用した。その経験をAI学習データの利用追跡へ応用したい」と説明すれば、再現性のある強みとして伝わります。
メディア業界からの転職なら、記事や映像の制作工程、権利処理、更新頻度を理解していることも価値になり得ます。技術だけの競争に見えても、データが生まれる現場を理解する人がいなければ、適切な加工条件は決めにくいからです。業界知識を捨ててAIへ移るのではなく、業界知識とデータ技術の組み合わせを作るイメージが近いでしょう。
✅ 90日で始める生成AIデータエンジニア転職の準備
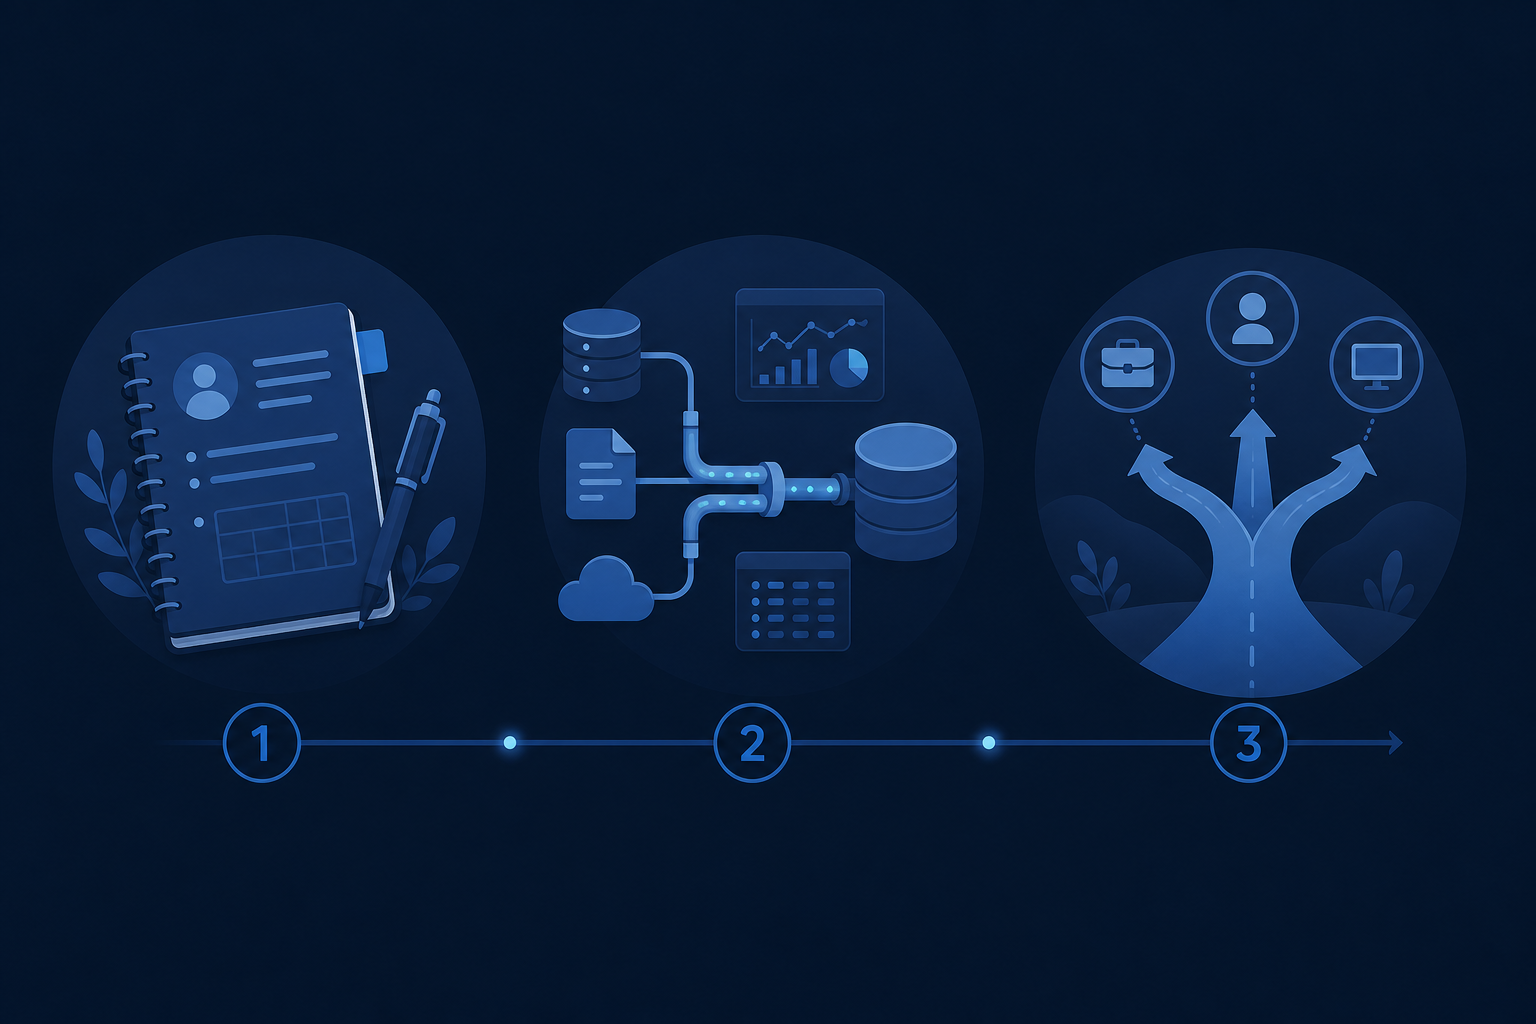
まず30日間は、過去の仕事をデータのライフサイクルに沿って分解します。収集元、加工処理、保存先、利用者、権限、監視、廃棄まで書き出し、自分が決めたことと他部門が決めたことを分けてください。「データ基盤を担当」という一行より、責任範囲がはっきりします。
次の30日間では、公開データを使った小さな成果物を作ります。複数の文書を収集し、出典URL、取得日時、ライセンス、加工履歴をメタデータとして保存。入力文書に不審な命令が含まれる場合は隔離し、処理結果をログへ残すところまで実装するとよいでしょう。大規模モデルを一から学習する必要はありません。安全で説明可能なデータパイプラインを見せることが目的です。
最後の30日間で求人票を比較します。「AIエンジニア」という職種名だけで選ばず、データ品質、ガバナンス、セキュリティ、API、顧客導入など、自分の経験と重なる言葉を拾ってください。面接用には、問題、判断、実装、結果、改善点の順で二つか三つの事例を用意しておくと安心です。
| 期間 | 取り組むこと | 完成させたいもの |
|---|---|---|
| 1〜30日 | 過去案件の責任範囲とデータの流れを棚卸し | 職務経歴書に使える実績メモ |
| 31〜60日 | 出典・権利・加工履歴を管理する小規模な基盤を試作 | 設計図、コード、評価結果、運用手順 |
| 61〜90日 | 求人比較と面接回答の準備 | 企業別の確認項目と経験エピソード |
💡 生成AI分野への転職準備では、最新ツールをいくつ知っているかだけでなく、「データを安全に使える状態へ整え、その状態を維持した経験」を言語化することが重要です。
GaranAIが示したのは、価値ある日本語コンテンツを保護しながらAI開発へ生かすという、簡単には解けない課題です。だからこそ、データ基盤、セキュリティ、権利管理、品質運用をつなげられる人には挑戦の余地があります。今の職歴にモデル開発がなくても、隣接する経験から一歩ずつ準備してみてください。
データ基盤の経験を生かせる次のキャリアをCareer Central AIで探す
参照元
🔗 出典・参照リンク
- ソフトバンク「データエコシステム基盤『GaranAI』のベータ版を提供開始」(2026年7月22日公開、2026年7月22日15時00分 JST確認)
- ソフトバンク法人向け「GaranAI(β版)の取り組み」(2026年7月22日公開、2026年7月22日15時00分 JST確認)
- 経済産業省「半導体・デジタル産業戦略の進捗状況」(2025年12月23日、2026年7月22日15時00分 JST確認)
- 衆議院「第217回国会 総務委員会 第3号」(2025年2月18日、2026年7月22日15時00分 JST確認)